Scraping Data Turtles with Frames & iFrames
🐢 Web Scraping Turtles via iFrames
Pada tutorial ini, kita akan melakukan web scraping pada halaman:
🔗 Turtles All the Way Down: Frames & iFrames
Situs ini merupakan latihan menarik untuk memahami bagaimana cara scraping konten yang dimuat melalui frames atau iFrames.
🎯 Tujuan Scraping
- Mendapatkan informasi tentang keluarga kura-kura dari iframe tersembunyi
- Menelusuri halaman detail setiap item
- Mengekstrak data:
Family NameCommon NameYear DiscoveredDiscoverer
🛠️ Setup Environment
Sebelum mulai coding, pastikan sudah membuat environment menggunakan:
1
python -m venv myenv
Lalu mengaktifkan environment di Windows:
1
.\myenv\Scripts\activate
Install library yang dibutuhkan:
1
2
pip install requests
pip install beautifulsoup4
🔍 Memahami Struktur Situs
Halaman utama sebenarnya hanya memuat iframe, di mana konten aslinya disisipkan dari URL lain. Untuk mendapatkan data:
Kita harus ambil tag iframe dari halaman utama.
Ambil konten URL di dalam iframe (yang berisi daftar kura-kura).
Setiap kartu kura-kura memiliki tombol Learn More yang menuju ke halaman detail.
Dari halaman detail itulah kita bisa mengambil data tahun ditemukan dan penemunya dari paragraf seperti ini:
1
2
3
<p class="lead">
    The <span class="family-name">Chelydridae</span> family of turtles — more commonly known as "<strong class="common-name">Snapping turtles</strong>" — were first discovered in 1831 by Gray.
</p>
💻 Kode Lengkap Python untuk Scraping
Berikut adalah kode Python untuk mengekstrak data kura-kura lengkap dengan parsing tahun dan penemunya:
- Import library yang sudah dijelaskan
1
2
3
4
5
6
import requests
from bs4 import BeautifulSoup
import urllib.parse
import csv
import time
import re
📌 Fungsi:
requestsuntuk mengambil data dari web.BeautifulSoupuntuk memparsing HTML.urllib.parseuntuk menggabungkan URL relatif dan absolut.csvuntuk menyimpan data hasil scraping ke file.timeuntuk delay antar request (menghindari ban IP).reuntuk mengambil informasi tahun dan penemu menggunakan regular expression
Inisialisasi URL dan Tempat Menyimpan Data
1
2
parent_url = "https://www.scrapethissite.com/pages/frames/"
all_turtles_data = []
Ambil dan Parse Halaman Induk
1
2
3
parent_response = requests.get(parent_url)
parent_response.raise_for_status()
parent_soup = BeautifulSoup(parent_response.text, 'html.parser')
📌 Fungsi: Mengambil HTML dari halaman utama dan parsing untuk mencari iframe.
- Ambil dan Parse Halaman iframe
1
2
3
4
5
iframe_tag = parent_soup.find('iframe', {'id': 'iframe'})
iframe_src = iframe_tag['src']
iframe_url = urllib.parse.urljoin(parent_url, iframe_src)
iframe_response = requests.get(iframe_url)
iframe_soup = BeautifulSoup(iframe_response.text, 'html.parser')
📌 Fungsi: Mendapatkan URL iframe dan parsing isinya yang berisi daftar kura-kura.
- Temukan dan Iterasi Setiap Keluarga Kura-kura ```python turtle_items = iframe_soup.find_all(‘div’, class_=’col-md-4’)
for item in turtle_items: family_name = item.find(‘h3’, class_=’family-name’).text.strip() detail_url = urllib.parse.urljoin(iframe_url, item.find(‘a’)[‘href’])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16

📌 Fungsi:

Ambil Family Name dari tiap elemen dan siapkan URL menuju halaman detail masing-masing.

- Kunjungi Halaman Detail dan Ekstrak Informasi
```python
    detail_response = requests.get(detail_url)
    detail_soup = BeautifulSoup(detail_response.text, 'html.parser')

    description = detail_soup.find('p', class_='lead').text.strip()
    match = re.search(r'first discovered in (\d{4}) by ([\w\s.]+)', description)
    year = match.group(1) if match else ''
    discoverer = match.group(2).strip() if match else ''

    common_name = detail_soup.find('strong', class_='common-name').text.strip()
📌 Fungsi:
Menemukan paragraf deskripsi, menggunakan regex untuk menemukan tahun dan nama penemu, mengambil nama umum kura-kura.
- Simpan data ke list
1
2
3
4
5
6
    all_turtles_data.append({
        'Family Name': family_name,
        'Common Name': common_name,
        'Year Discovered': year,
        'Discoverer': discoverer
    })
- Simpan hasil ke CSV ```python csv_file_name = ‘turtle_data.csv’ csv_headers = [‘Family Name’, ‘Common Name’, ‘Year Discovered’, ‘Discoverer’]
with open(csv_file_name, ‘w’, newline=’’, encoding=’utf-8’) as f: writer = csv.DictWriter(f, fieldnames=csv_headers) writer.writeheader() writer.writerows(all_turtles_data) ```
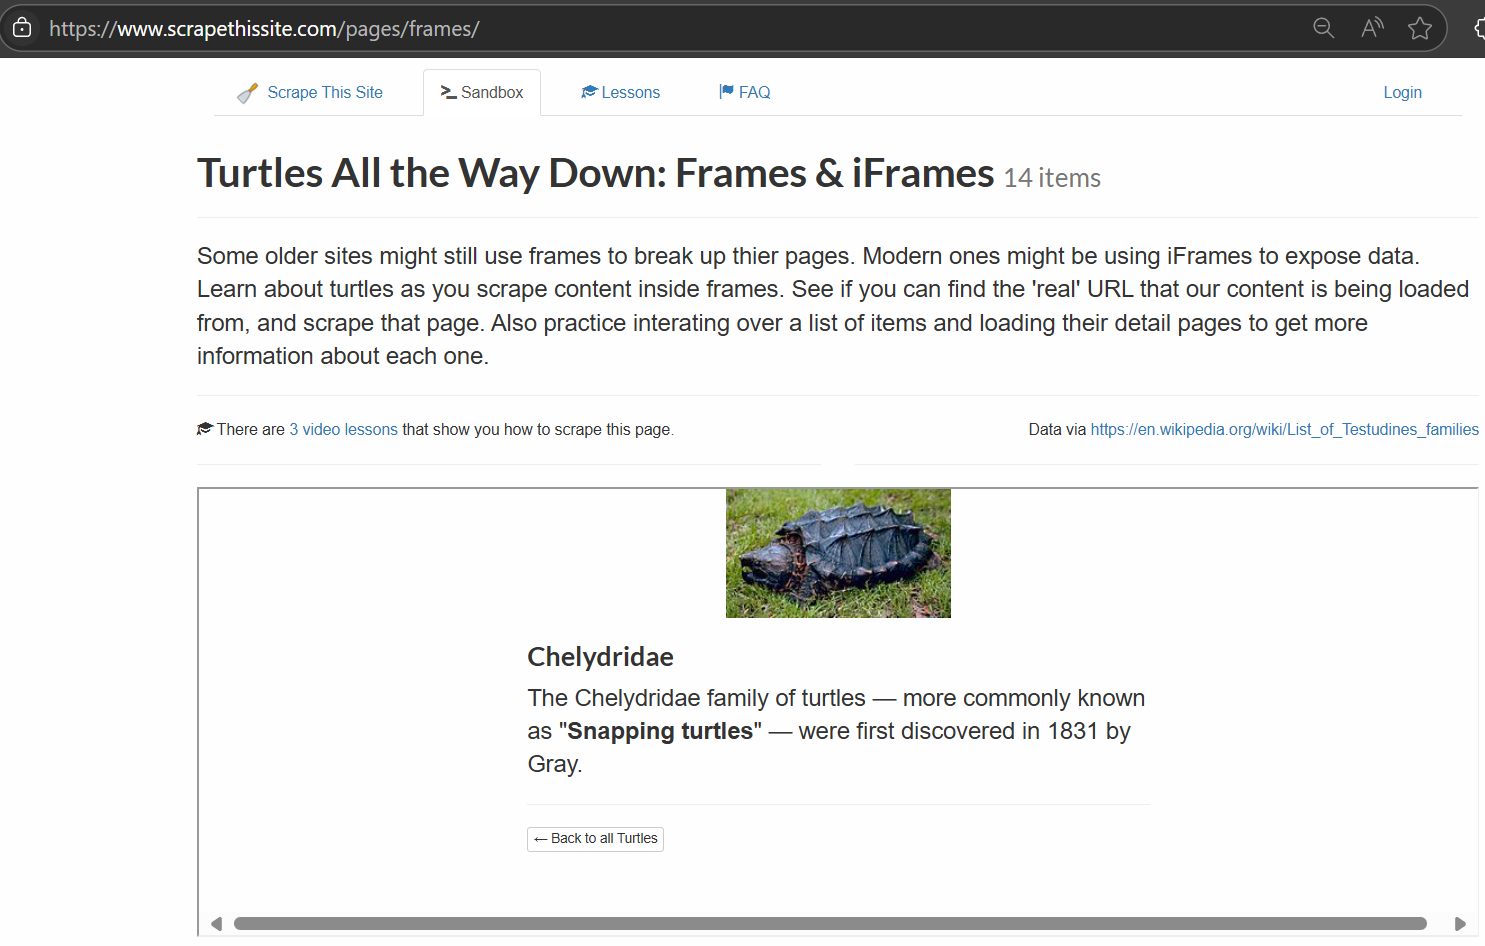 Data yang ingin disrapping
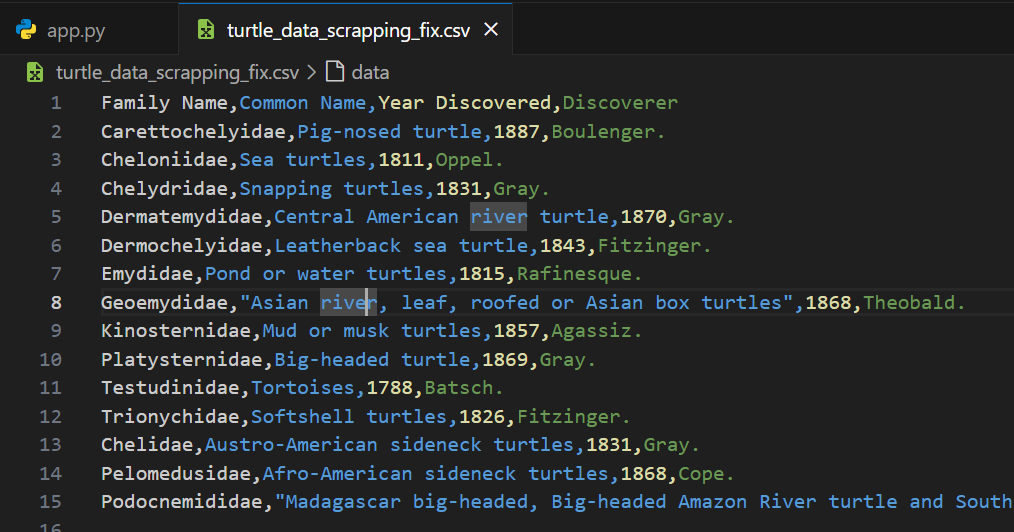
Data setelah discrapping